开源Mod解锁RTX 30/40系张量核心限制,AI计算性能接近翻倍
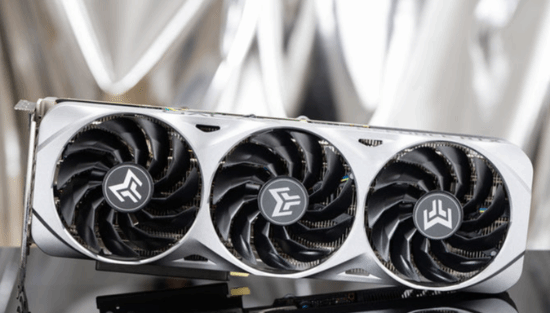
两个开源项目近日分别针对NVIDIA RTX 30系和RTX 40系显卡,解锁了FP16/BF16张量核心的完整指令发射速率,在AI计算场景中实现接近翻倍的性能提升。
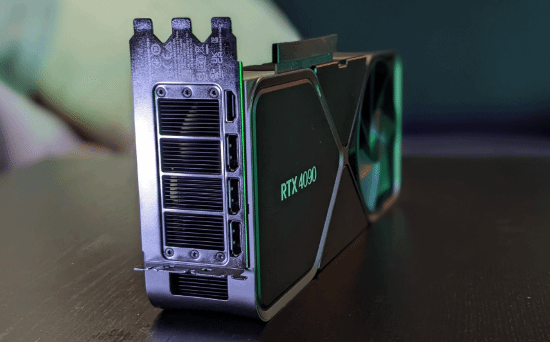
针对RTX 40系,开发者JustAResearcher发布Linux内核模块gpu-unlock-ada,在官方驱动加载前覆写SM速度选择寄存器以绕过限制。RTX 4090的FP16/FP32累加吞吐从165.6 TFLOPS提升至331.6 TFLOPS,BF16从165.5提升至330.6 TFLOPS。该解锁在PCIe功能级复位和原厂驱动初始化后依然生效,INT8和标量FP32性能保持在基线附近。项目还覆盖RTX 4070 Ti SUPER(95.0至189.9 TFLOPS)和RTX 4060 Ti 16GB。
RTX 30系方面,开发者Zagitta的gpu-unlock项目采用类似思路,结合CMP矿卡解锁技术与早期内核模块初始化方法,支持GA102、GA103、GA104和GA106芯片。RTX 3090 Ti的BF16稠密矩阵乘法性能从87.50 TFLOPS升至157.41 TFLOPS,提升80%;TF32从42.58升至82.61 TFLOPS,增幅94%;FP16提升约35%。用户报告显示RTX 3080 Ti的BF16从71.59升至113.98 TFLOPS,RTX 3080 10GB从约65升至110–113 TFLOPS,RTX 3070和RTX 3060 12GB提升幅度在73%至81%之间。
真实AI负载中,一位RTX 3090 Ti用户在ComfyUI测得58.6%的图像生成吞吐提升;vLLM的提示处理吞吐量提升33%,但LLM解码受限于显存带宽,token生成速度基本没有变化。目前没有证据表明这些解锁能提升游戏帧率或DLSS性能。
两个项目均运行在原厂NVIDIA驱动之下,无需修改驱动或刷写VBIOS,但以Linux内核模块形式实现,Windows下的UEFI方案仍处于实验阶段。任何此类修改都会使显卡失去保修,且结果并非普适——已有RTX 3080 Ti用户报告解锁流程完成但BF16性能未见提升。
更多游戏资讯与福利,尽在 GGAMen 福利中心,每日限免礼包 · 新游预约一站直达。
来源:原始报道
相关标签:开源Mod解锁RTX · 30/40系张量核心限制 · AI计算性能接近翻倍


最新内容
-
传闻中的 Lucia 扮演者在直播中回避大量 GTA6 评论后走红
-
Mass Effect 爆料:BioWare 某款被取消游戏的故事本将继承前作“所有”选择
-
开源Mod解锁RTX 30/40系张量核心限制,AI计算性能接近翻倍
-
PlayStation向玩家发送《GTA6》促销邮件,显示距11月19日发售剩26天
-
合作射击游戏Vincit公布:融合高速移动、子弹格挡与法术
-
EA新东家关闭BioWare工作室
-
近20万粉丝联署请愿拯救《质量效应》系列,BioWare关闭后配音演员发声支持
-
Team Ninja承认《卧龙2:凤火连天》阿尔法测试好评率仅25%
-
前技术总监透露被取消的《质量效应》新作曾计划继承三部曲全部选择
-
10月25日游戏促销:异度神剑2捆绑包39.94美元、P3R Switch 2版24.99美元